Scanner
Een afbeelding van een kleitablet selecteren of maken en aanbieden voor automatische analyse.
Vijfduizend jaar oud schrift, onderzocht met de mogelijkheden van moderne digitale technologie.
Cuneiform Lab is een digitaal onderzoeksproject van Rinus van Hagen. De applicatie onderzoekt hoe beeldherkenning en taalkundige gegevens kunnen helpen bij het herkennen en bestuderen van spijkerschrifttekens op afbeeldingen van Mesopotamische kleitabletten.
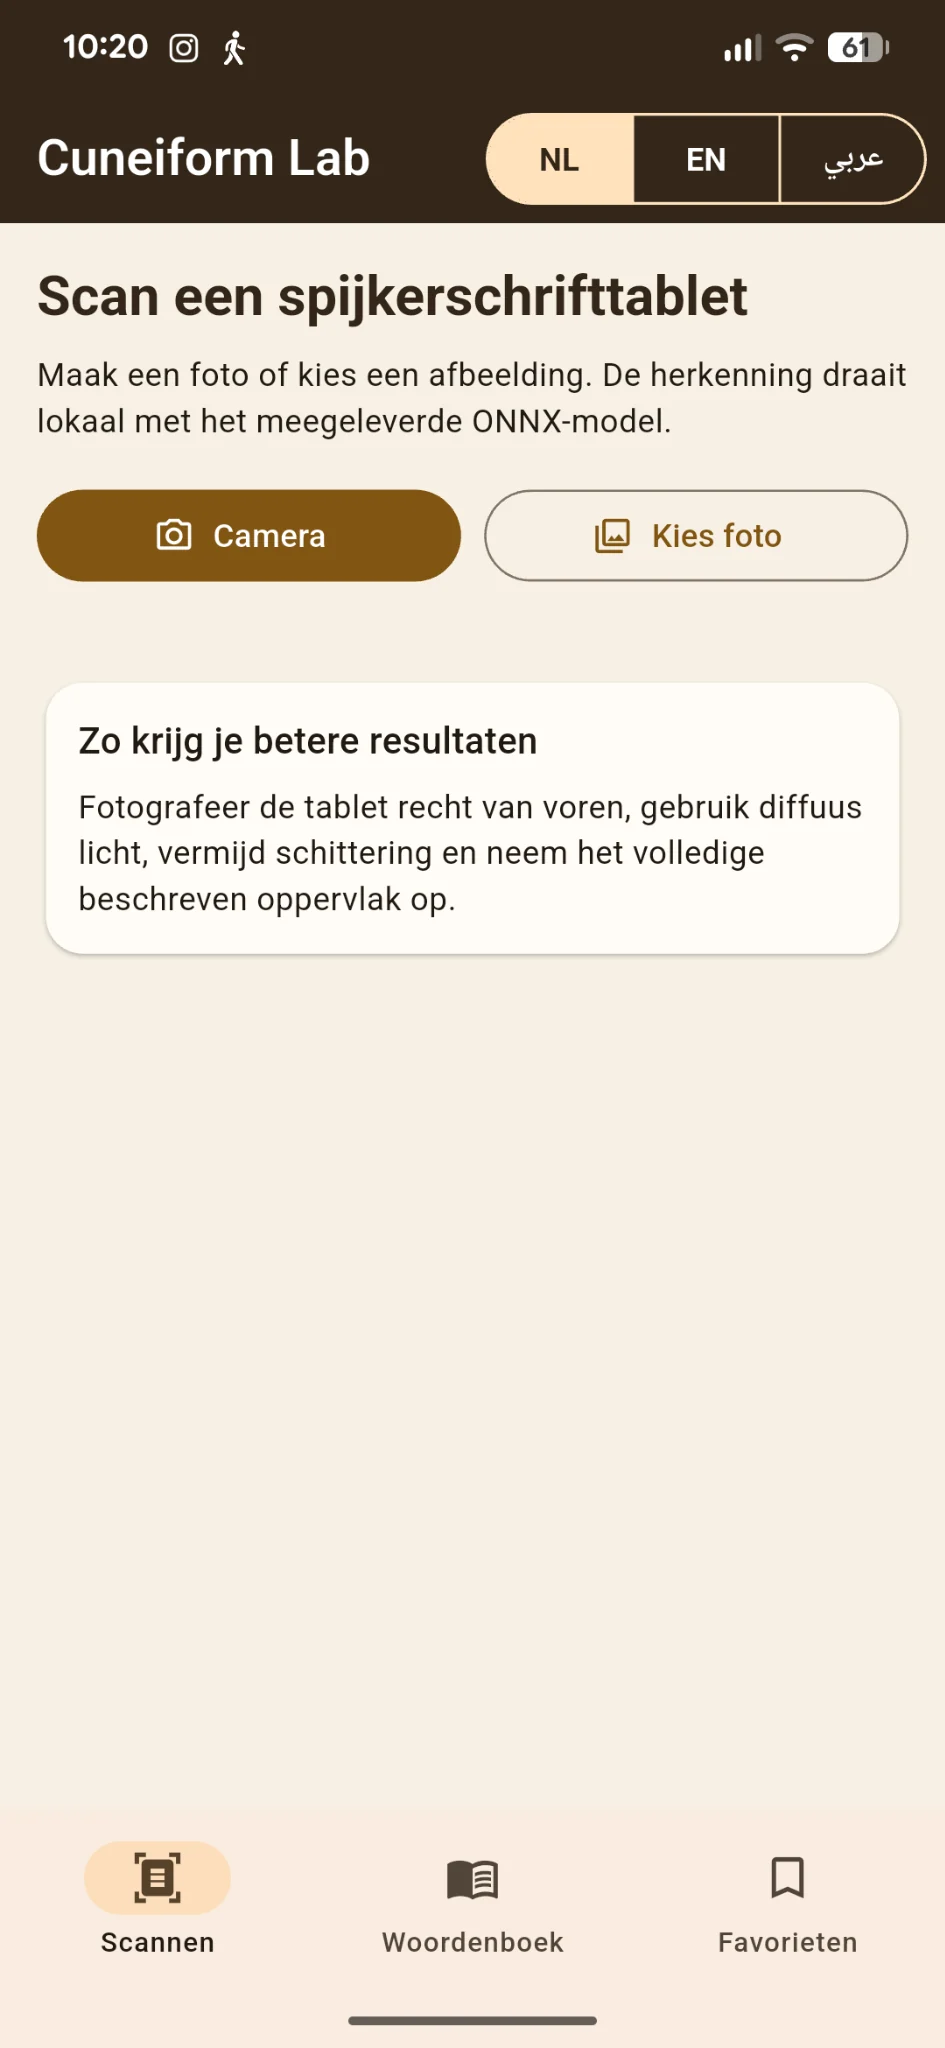
De app is ontworpen voor gebruik op een smartphone. De rustige, op klei en perkament geïnspireerde interface brengt de scanner, tekeninformatie en persoonlijke onderzoeksselectie samen.
De onderstaande schermbeelden tonen de huidige ontwikkelversie. De vormgeving en functies worden tijdens het testen verder verfijnd.
In de wigvormige indrukken op Mesopotamische kleitabletten ligt een uitzonderlijk rijke geschiedenis besloten.
De tekens werden gebruikt om economische transacties vast te leggen, maar ook om wetten, religieuze teksten, wetenschappelijke kennis, literatuur en historische gebeurtenissen te bewaren. Het lezen ervan vraagt om kennis van de tekenvormen, talen en historische context.
Cuneiform Lab verkent hoe digitale beeldherkenning onderzoekers kan ondersteunen bij het analyseren van deze bronnen. Een afbeelding van een tablet kan aan een herkenningsmodel worden aangeboden, waarna mogelijke tekenidentificaties met bijbehorende herkenningsscores worden getoond.
De applicatie verbindt beeldmateriaal met gegevens over schrifttekens en hun mogelijke taalkundige betekenis.
Een afbeelding van een kleitablet selecteren of maken en aanbieden voor automatische analyse.
Een neuraal netwerk analyseert visuele kenmerken en geeft mogelijke herkenningen met confidence scores.
Herkenningen kunnen worden verbonden met spijkerschrifttekens, Unicode, transliteraties en betekenissen.
De uitkomsten worden vergeleken met historische tekenvormen en moeten inhoudelijk worden gevalideerd.
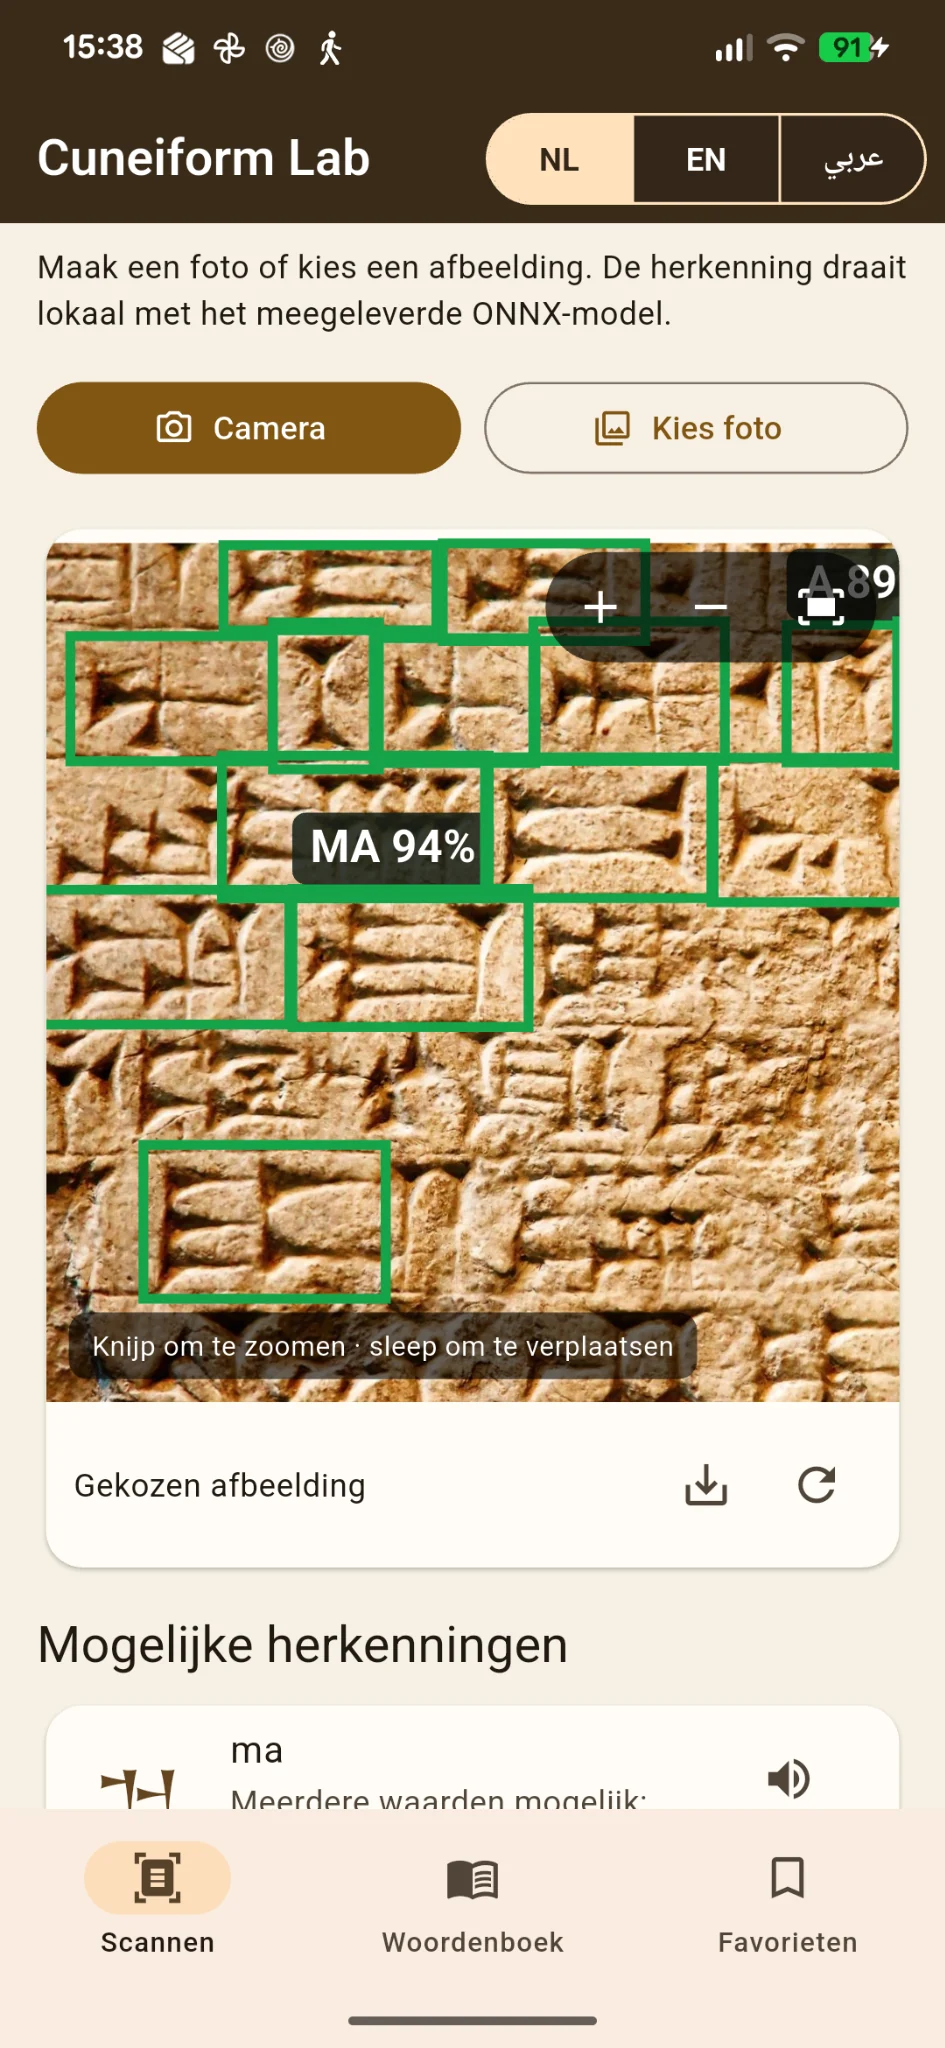
Na het selecteren van een afbeelding analyseert het model de zichtbare vormen. De resultaten verschijnen als kaders op de foto, met daaronder mogelijke tekenidentificaties en een modelscores.
Dit zijn suggesties van het model, geen automatische filologische conclusies. Juist daarom blijft controle aan de hand van het tablet, de tekstuele context en betrouwbare tekenlijsten onmisbaar.
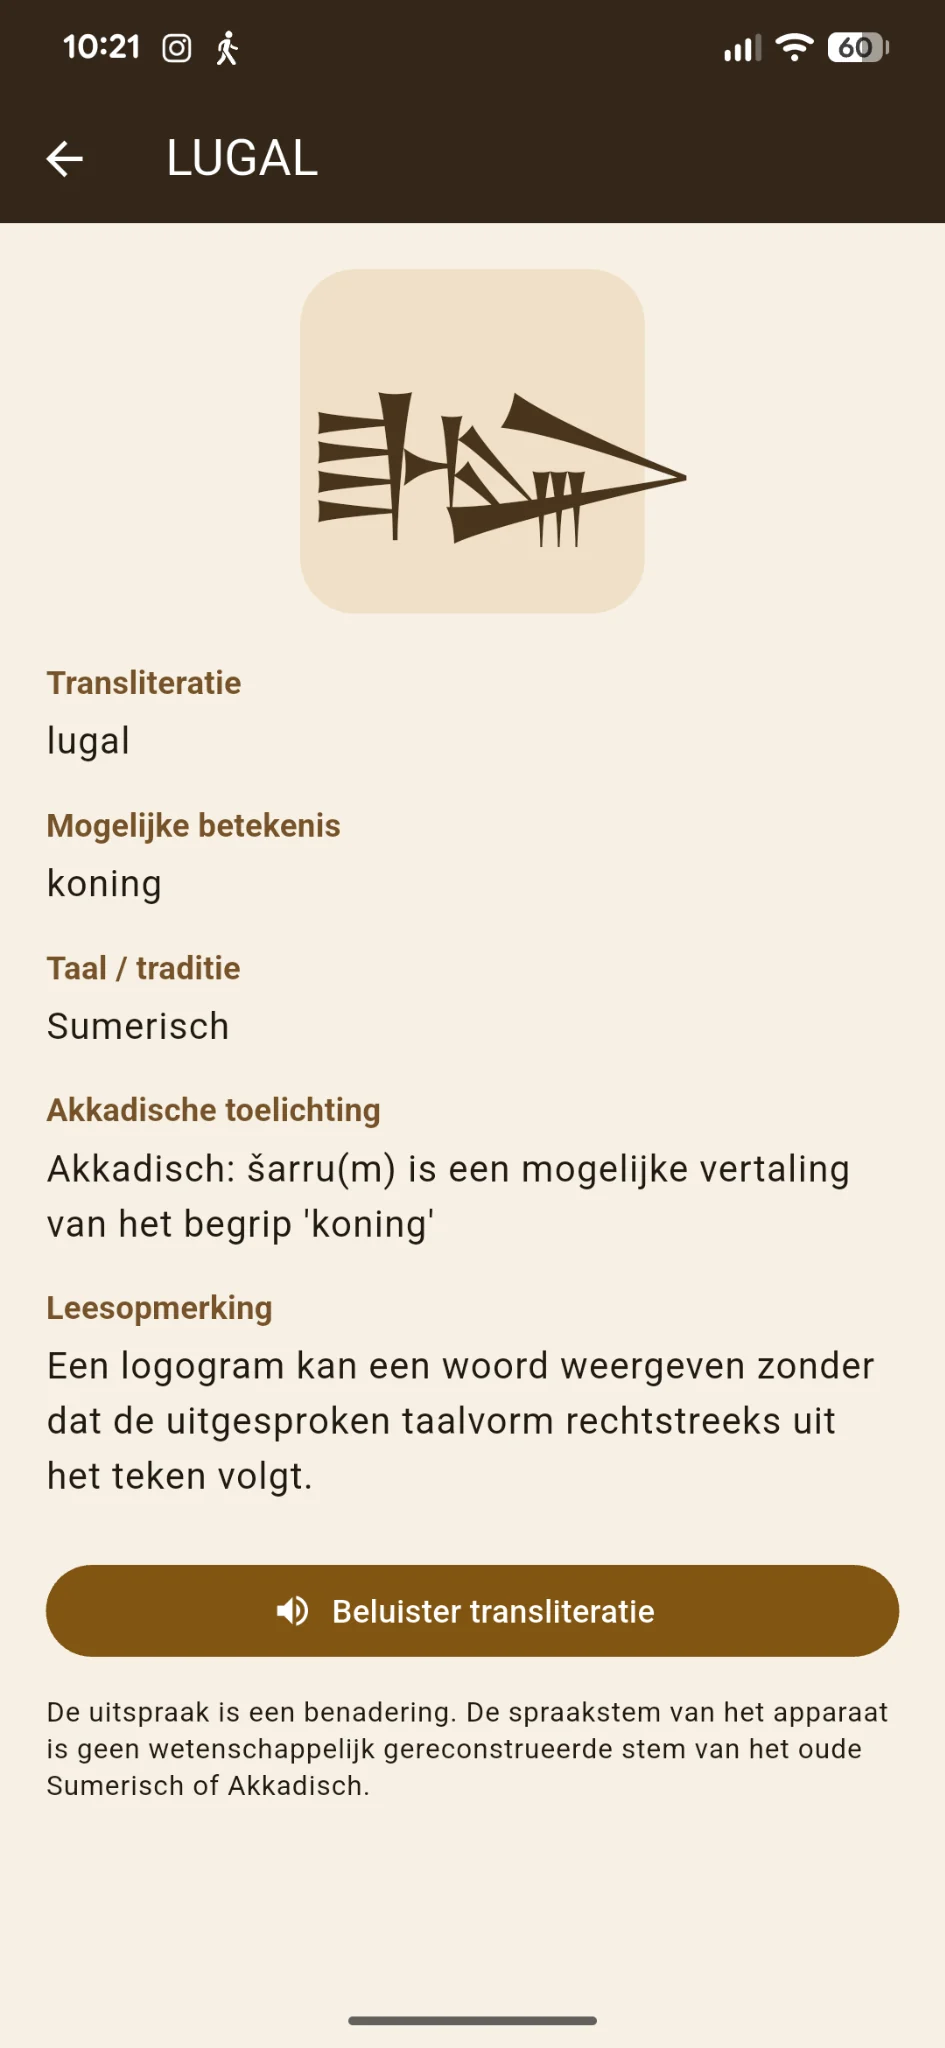
Het huidige herkenningsmodel werkt met 173 modelklassen. Bij een voorspelling toont de applicatie een confidence score: een indicatie van de mate waarin het model die uitkomst ondersteunt. Zo'n score is geen bewijs dat een identificatie historisch of taalkundig juist is.
Spijkerschrifttekens kunnen verschillende waarden hebben, afhankelijk van taal, periode en context. Beschadigingen en variaties in schrijfwijze maken herkenning bovendien ingewikkeld. Daarom worden modeluitkomsten beschouwd als onderzoeksaanwijzingen die door vergelijking met betrouwbare bronnen moeten worden gecontroleerd.
Het digitale woordenboek wordt verder uitgebreid met tekenvormen, transliteraties, betekenissen en aanvullende informatie. Ook de relatie tussen de 173 modelklassen en de historische tekens vraagt om systematische verificatie.
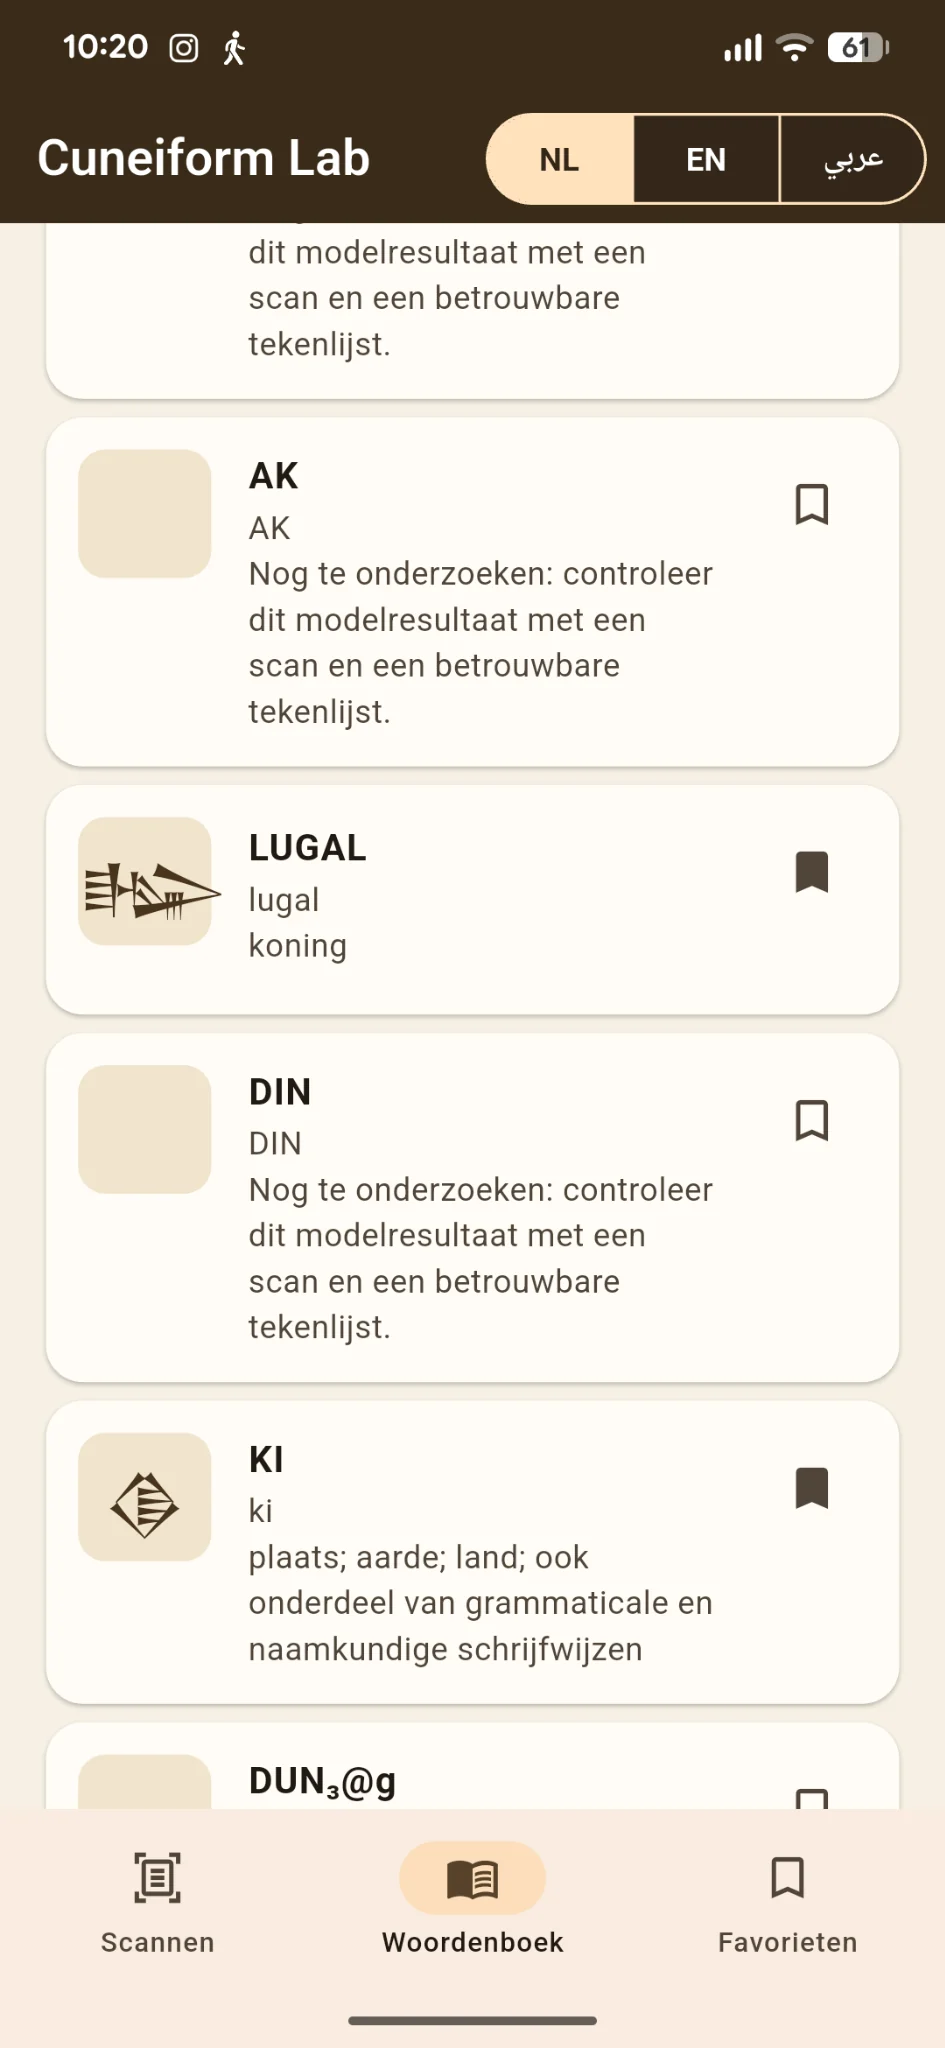
De woordenboekfunctie brengt tekenvormen samen met transliteraties, mogelijke betekenissen en taalkundige toelichtingen. Waar relevant wordt ook de relatie met Sumerische en Akkadische vormen toegelicht.
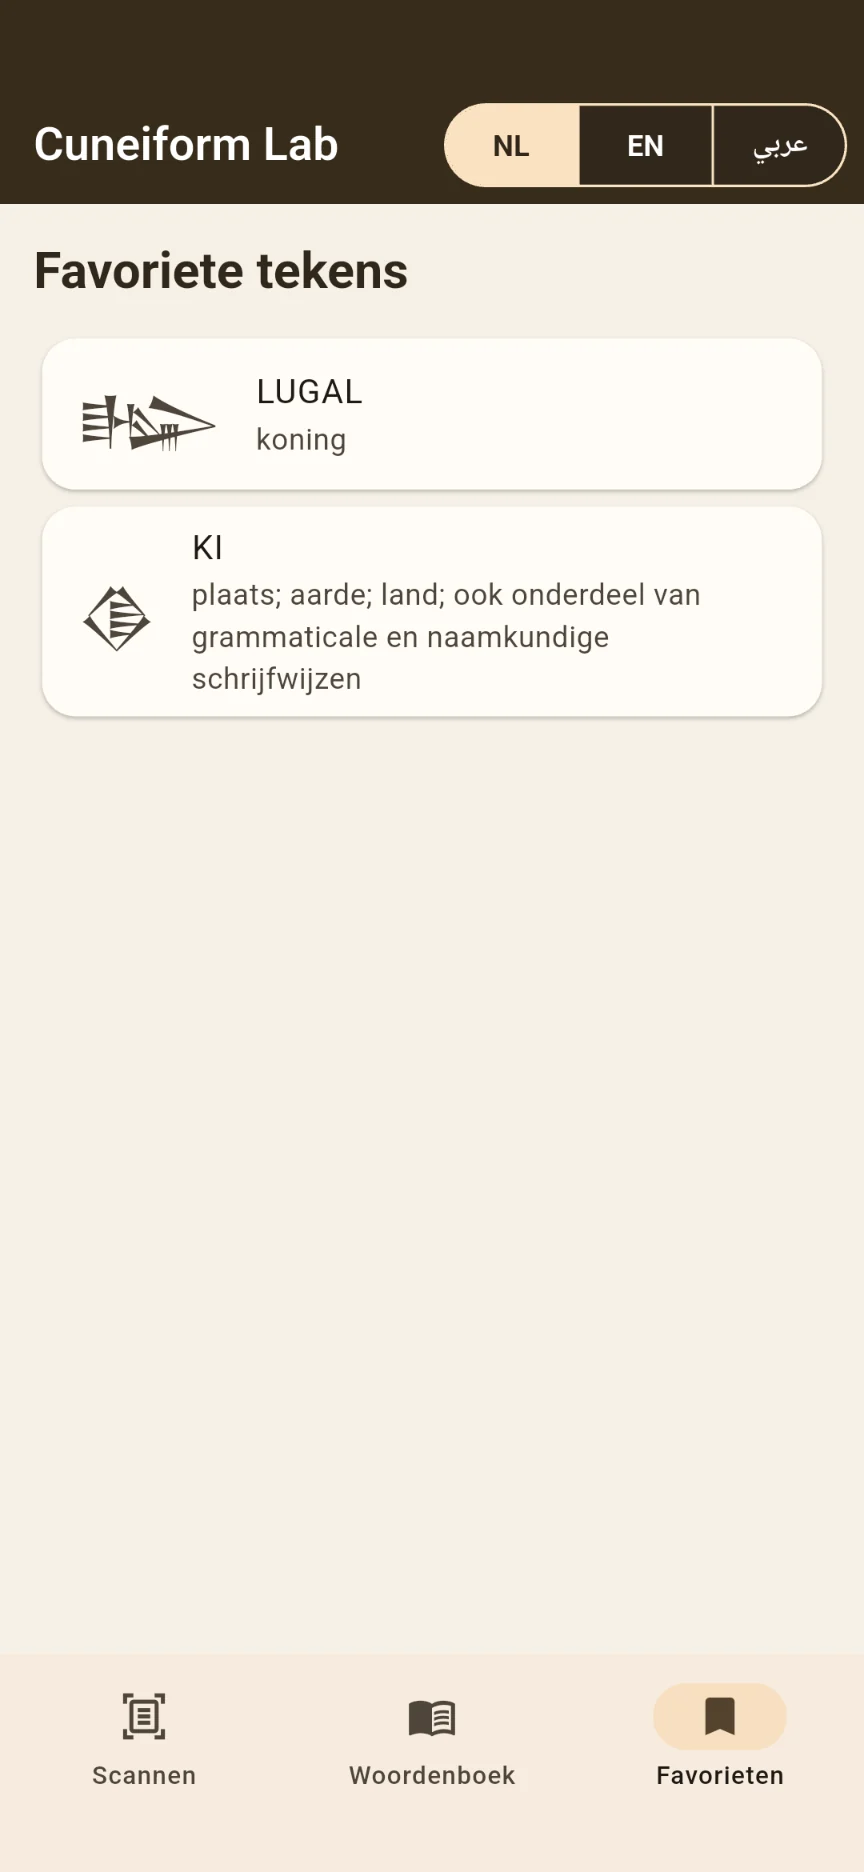
Met Favorieten kunnen interessante tekens worden bewaard om ze later opnieuw te bekijken. Zo groeit de app niet alleen uit tot een scanner, maar ook tot een kleine digitale werkruimte voor het bestuderen van spijkerschrift.
ONNX-modelarchitectuur, gegevensverwerking, statistische evaluatie en de grenzen van automatische herkenning
Cuneiform Lab is een experimentele mobiele toepassing die de documentatie en voorlopige automatische herkenning van spijkerschrifttekens onderzoekt. De applicatie is ontwikkeld met Flutter voor mobiele apparaten en maakt gebruik van een ONNX-model voor beeldgebaseerde detectie. In de huidige technische configuratie bevat het model 173 klassen. De centrale onderzoeksvraag is niet alleen of een model een teken kan lokaliseren, maar vooral of de modeluitvoer op betrouwbare wijze kan worden verbonden met een filologisch verantwoorde identificatie, transliteratie en betekenis.
Deze publicatie beschrijft de technische opzet, kwantificeert enkele controleerbare eigenschappen van de modelbestanden en formuleert een reproduceerbaar validatiekader. Omdat een onafhankelijk samengestelde en geannoteerde testset en gevalideerde prestatiestatistieken nog ontbreken, worden geen precisie-, recall- of mAP-scores als onderzoeksresultaat gepresenteerd.
Het Mesopotamische spijkerschrift behoort tot de vroegste schrifttradities die in omvangrijke administratieve, juridische, literaire en religieuze corpora zijn overgeleverd. De interpretatie van een teken is echter nooit uitsluitend een kwestie van visuele vormherkenning. Een teken kan door periode, plaats, schrijftraditie, materiaal, schrijfrichting en individuele scribale gewoonten aanzienlijke grafische variatie vertonen. Bovendien kunnen grafisch verwante tekens in verschillende contexten uiteenlopende waarden hebben, terwijl één teken meerdere logografische, syllabische of determinatieve functies kan vervullen.
Automatische beeldherkenning biedt mogelijkheden om grote hoeveelheden documentatie systematischer te ontsluiten. Een computervisionsysteem kan kandidaatregio’s in een afbeelding lokaliseren en die regio’s vergelijken met aangeleerde klassen. De uitkomst moet evenwel worden beschouwd als een hypothese die filologisch en archeologisch moet worden getoetst. De context van het tablet, de grammaticale omgeving en de tekstuele conventies blijven essentieel. Cuneiform Lab is daarom een onderzoeksinstrument en documentatieomgeving, niet een autonome vervanging van de assyrioloog of epigraaf.
De mobiele applicatie is gebouwd met Flutter en is bedoeld voor Android en iOS. De herkenningscomponent maakt gebruik van een ONNX-model. ONNX (Open Neural Network Exchange) biedt een gestandaardiseerde representatie waarmee modellen buiten hun oorspronkelijke trainingsomgeving kunnen worden uitgevoerd. De gebruiker kan een afbeelding aanleveren via de camera of fotogalerij. De herkenningscomponent verwerkt de afbeelding en produceert kandidaatdetecties met bijbehorende scores en begrenzingscoördinaten.
Figuur 1. Schematische gegevensstroom van tabletbeeld naar modeluitvoer en woordenboek. De pijlen geven functionele stappen weer; zij bewijzen niet dat iedere stap al volledig geautomatiseerd of wetenschappelijk gevalideerd is.
De applicatie presenteert de uitvoer in herkenningskaarten. Daarnaast wordt gewerkt aan een woordenboek waarin tekens gekoppeld worden aan Unicode, transliteratie, betekenis en taalkundige toelichting. Favorieten ondersteunen het bewaren en later vergelijken van geselecteerde resultaten.
In de huidige projectconfiguratie is een oorspronkelijk PyTorch-checkpoint van circa 875 MB genoemd. De geëxporteerde ONNX-versie, aangeduid als detr_173.onnx, heeft een bestandsgrootte van circa 167 MB. De relatieve reductie in bestandsgrootte is:
Figuur 2. Bestandsgrootte van de twee genoemde modelbestanden. Waarden zijn afgerond en uitsluitend bedoeld als technische bestandsvergelijking.
De ONNX-versie vertegenwoordigt daarmee ongeveer 19,1% van de omvang van het genoemde checkpoint. Dit is een vergelijking van opslagomvang, geen benchmark van snelheid, geheugenverbruik, energiegebruik of herkenningskwaliteit. Een kleinere modelrepresentatie hoeft niet automatisch sneller of nauwkeuriger te zijn; daarvoor zijn metingen op de daadwerkelijke doelapparaten nodig.
Bij inspectie van de modeluitvoer zijn de volgende tensorvormen gerapporteerd: scores met dimensies (6, 1, 300, 173) en boxes met dimensies (6, 1, 300, 4). Vermenigvuldiging van de dimensies levert:
Deze aantallen beschrijven de omvang van de gerapporteerde tensors. Zij mogen niet zonder nadere inspectie van de modelconfiguratie worden geïnterpreteerd als 311.400 afzonderlijke herkenningen of als zes onafhankelijke afbeeldingen. De betekenis van de dimensies moet worden vastgesteld aan de hand van de modelarchitectuur, exportinstellingen en runtime-interface. De 300 posities kunnen bijvoorbeeld betrekking hebben op kandidaatvoorspellingen per uitvoerlaag, maar die interpretatie moet technisch worden bevestigd.
Ook de term confidence score vraagt om voorzichtigheid. Een score uit een neuraal netwerk is niet automatisch een gekalibreerde waarschijnlijkheid. Indien de uitvoer logits bevat, kan een softmax-transformatie worden toegepast:
Hierin is zᵢ de logit voor klasse i. Deze formule is alleen passend wanneer de modeluitvoer daadwerkelijk logits bevat en de gebruikte dimensie overeenkomt met de bedoelde klassendistributie. Zelfs dan zegt een hoge softmax-score niet zonder meer dat de identificatie juist is. Kalibratie vereist een afzonderlijke vergelijking tussen voorspelde zekerheid en empirisch waargenomen correctheid.
Het getal 173 verwijst naar het aantal modelklassen in de huidige export. Het is wetenschappelijk onjuist om daaruit af te leiden dat alle 173 klassen al eenduidig overeenkomen met 173 geïdentificeerde spijkerschrifttekens. Daarvoor is een expliciete mapping nodig waarin ten minste het numerieke klasse-index, de oorspronkelijke model-labelnaam, het bedoelde teken, de Unicode-codepositie en de transliteratie worden vastgelegd.
class_idNumerieke klasse-index die het model teruggeeftmodel_labelLabel zoals vastgelegd in de trainings- of exportconfiguratiesign_unicodeUnicode-codepositie of tekenrepresentatietransliterationWetenschappelijke transliteratiemeaning_nl / meaning_enBeknopte betekenis of functie, met bronverwijzingvalidation_statusOngecontroleerd, voorlopig, gecontroleerd of afgewezenreferenceBron, catalogus, tablet of publicatie waarop de identificatie berustTabel 1. Voorgesteld dataschema voor een controleerbare mapping. Dit is geen reeds volledig ingevulde inventaris. Het onderscheid tussen modelklasse en filologisch geïdentificeerd teken moet in de applicatie zichtbaar blijven.
Een onzekere of nog niet gecontroleerde koppeling mag niet als vaststaand woordenboekfeit worden gepresenteerd.
Een overtuigende evaluatie vereist een referentieset met afbeeldingen waarin tekenregio’s en tekenidentiteiten onafhankelijk zijn geannoteerd. De annotatie moet waar mogelijk door deskundigen worden gecontroleerd, met expliciete regels voor beschadigde, overlappende, gedeeltelijk zichtbare en grafisch ambigue tekens. De testset moet bovendien gescheiden blijven van de data waarmee het model is getraind of afgesteld. Anders ontstaat het risico dat de gemeten prestaties te optimistisch zijn.
Precisie geeft aan welk aandeel van de positieve voorspellingen correct is. Recall geeft aan welk aandeel van de relevante referentiegevallen door het systeem wordt teruggevonden:
TP staat voor true positives, FP voor false positives en FN voor false negatives. Een systeem kan een hoge precisie hebben doordat het slechts weinig detecties doet, maar daardoor veel tekens missen. Omgekeerd kan een hoge recall gepaard gaan met veel foutieve kandidaatdetecties. Beide maten moeten daarom gezamenlijk worden gerapporteerd.
Bij objectdetectie wordt de ruimtelijke overeenkomst tussen een voorspelde begrenzingsbox en een referentiebox vaak uitgedrukt met Intersection over Union (IoU):
Figuur 3. Schematische illustratie van de overlap tussen een referentiebox en een voorspelde box. De IoU-waarde is de verhouding tussen het overlappende gebied en de gezamenlijke omhullende oppervlakte.
Een detectie wordt bij een gekozen IoU-drempel als ruimtelijk passend beschouwd wanneer de overlap die drempel bereikt. De gekozen drempel moet in de methode worden vermeld; verschillende drempels kunnen tot verschillende prestatiecijfers leiden.
Average Precision (AP) vat de precisie-recallrelatie voor een klasse samen. Mean Average Precision (mAP) is het gemiddelde van AP over de geëvalueerde klassen, eventueel ook gemiddeld over meerdere IoU-drempels. De exacte definitie moet worden vermeld, bijvoorbeeld mAP bij IoU 0,50 of een gemiddelde over een reeks drempels. Zonder die specificatie is een mAP-getal niet goed vergelijkbaar met andere studies.
Omdat de visuele interpretatie van spijkerschrift soms ambigu is, kan ook de overeenstemming tussen menselijke annotatoren worden onderzocht. Cohen’s kappa corrigeert de geobserveerde overeenstemming voor overeenstemming die op basis van toeval kan worden verwacht:
Hierin is pₒ de geobserveerde overeenstemming en pₑ de verwachte overeenstemming op basis van toeval. Kappa is geen vervanging voor inhoudelijke filologische beoordeling, maar kan helpen om de reproduceerbaarheid van annotaties inzichtelijk te maken.
Tijdens praktische tests zijn herkenningskaarten met kandidaatlabels en scores waargenomen. In afzonderlijke voorbeelden zijn onder meer de labels A, MA en NU met hoge weergegeven scores verschenen. Ook zijn voorbeelden van GAL en AN als correct herkend beoordeeld; MU is in meerdere handmatig gecontroleerde voorbeelden als correct beschouwd. Zulke waarnemingen zijn waardevol voor het opsporen van fouten en het verbeteren van de woordenboekkoppeling, maar vormen geen representatieve steekproef.
Een handmatig gecontroleerd voorbeeld bewijst niet dat alle toekomstige voorspellingen van dezelfde klasse correct zijn. Daarom moeten observaties worden opgeslagen als individuele validatiegevallen, met de oorspronkelijke afbeelding, datum, modelversie, voorspelling, score, menselijke beoordeling en eventuele toelichting. Pas wanneer een voldoende grote, onafhankelijke testset is opgebouwd, kunnen algemene prestatiecijfers worden berekend.
Naast herkenningskwaliteit moet de praktische werking op mobiele hardware worden onderzocht. Relevante meetvariabelen zijn onder meer laadtijd van het model, verwerkingstijd per afbeelding, piekgeheugengebruik, energieverbruik en stabiliteit bij verschillende afbeeldingsresoluties. Metingen moeten op een vastgelegde apparaatconfiguratie worden uitgevoerd en meerdere keren worden herhaald.
Rapporteer naast het gemiddelde ook de spreiding, bijvoorbeeld standaarddeviatie en mediaan. De mediaan is minder gevoelig voor incidentele uitschieters. Noteer steeds apparaatmodel, besturingssysteem, runtimeversie, modelbestand, invoerresolutie en eventuele voorbewerking. Alleen zo kunnen latere versies op een zinvolle manier worden vergeleken.
De belangrijkste beperking is op dit moment de onzekerheid over de volledige relatie tussen de 173 modelklassen en de bedoelde tekenidentiteiten. Ook de precieze betekenis van de uitvoertensoren moet aan de hand van de modelconfiguratie worden bevestigd. Verder ontbreken vooralsnog gepubliceerde, reproduceerbare evaluaties op een onafhankelijk geannoteerde testset. Daarom kunnen geen algemene nauwkeurigheidspercentages worden toegekend.
Er zijn daarnaast inhoudelijke uitdagingen. Een teken kan beschadigd of gedeeltelijk afgebroken zijn; de klei kan vervormd zijn; lichtval en camerahoek kunnen de zichtbaarheid beïnvloeden. Een teken kan deel uitmaken van een ligatuur of in een dicht opeengepakte tekstregel staan. Ten slotte is de grafische identiteit niet hetzelfde als de lexicale of grammaticale functie. Het woordenboek moet daarom niet alleen een label tonen, maar waar mogelijk ook context, alternatieve waarden en bronverwijzingen ondersteunen.
Cuneiform Lab vormt een experimentele stap in de richting van digitale ondersteuning bij de documentatie van Mesopotamisch spijkerschrift. De combinatie van een mobiele Flutter-applicatie, een ONNX-model met 173 klassen, herkenningsscores en een groeiend woordenboek maakt het mogelijk om beeldherkenning en filologische gegevens in één werkomgeving te onderzoeken. De huidige technische gegevens laten zien dat de ONNX-export aanzienlijk kleiner is dan het genoemde oorspronkelijke checkpoint, maar zeggen op zichzelf niets over de kwaliteit van de herkenning.
De volgende onderzoeksfase moet beginnen met het reconstrueren en controleren van de 173 klasse-labels. Daarna kan een versiebeheerste woordenboekmapping worden opgebouwd en kan een onafhankelijke testset worden samengesteld. Op basis daarvan kunnen precisie, recall, IoU en mAP worden berekend, met transparante rapportage van onzekerheid en fouttypen. Parallel daaraan moeten mobiele prestaties systematisch worden gemeten.
De wetenschappelijke waarde van Cuneiform Lab zal uiteindelijk niet worden bepaald door een indrukwekkend percentage op het scherm, maar door de herleidbaarheid van iedere voorspelling: welk beeld is onderzocht, welke modelversie is gebruikt, welke klasse werd voorspeld, hoe is die gekoppeld aan een teken, wie heeft de identificatie gecontroleerd en op welke bronnen berust de interpretatie? Juist die controleerbaarheid kan de toepassing tot een bruikbaar hulpmiddel voor onderzoek en documentatie maken.
Cuneiform Lab is geen vervanging van de assyriologische methode. Het project onderzoekt hoe digitale technologie de bestudering van spijkerschrift kan ondersteunen: door afbeeldingen systematisch te analyseren, mogelijke tekenherkenningen zichtbaar te maken en informatie over tekens toegankelijker te verbinden.
De ontwikkeling blijft gericht op de wisselwerking tussen techniek en menselijke deskundigheid. Want pas wanneer herkenning wordt verbonden met taal, tekst en historische context, kan een teken werkelijk worden begrepen.